Elasticsearch面试题
文档查询步骤顺序
先看下整体的查询流程
单个文档
以下是从主分片或者副本分片检索文档的步骤顺序:
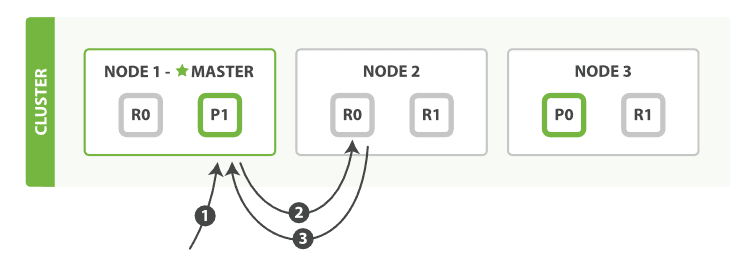
- 客户端向 Node 1 发送获取请求。
- 节点使用文档的 _id 来确定文档属于分片 0 。分片 0 的副本分片存在于所有的三个节点上。 在这种情况下,它将请求转发到 Node 2 。
- Node 2 将文档返回给 Node 1 ,然后将文档返回给客户端。
在处理读取请求时,协调结点在每次请求的时候都会通过轮询所有的副本分片来达到负载均衡。
在文档被检索时,已经被索引的文档可能已经存在于主分片上但是还没有复制到副本分片。 在这种情况下,副本分片可能会报告文档不存在,但是主分片可能成功返回文档。 一旦索引请求成功返回给用户,文档在主分片和副本分片都是可用的。
多个文档
使用 mget 取回多个文档的步骤顺序:
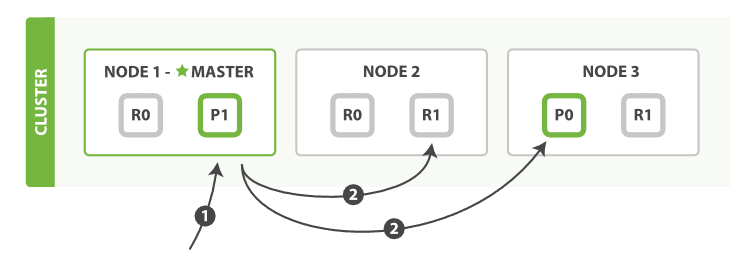
以下是使用单个 mget 请求取回多个文档所需的步骤顺序:
- 客户端向 Node 1 发送 mget 请求。
- Node 1 为每个分片构建多文档获取请求,然后并行转发这些请求到托管在每个所需的主分片或者副本分片的节点上。一旦收到所有答复, Node 1 构建响应并将其返回给客户端。
您能解释一下 X-Pack for Elasticsearch 的功能和重要性吗?
X-Pack 是与 Elasticsearch 一起安装的扩展程序。
X-Pack 的各种功能包括安全性(基于角色的访问,特权/权限,角色和用户安 全性),监视,报告,警报等。
Elasticsearch 中的节点(比如共 20 个),其中的 10 个选了 一个 master,另外 10 个选了另一个 master,怎么办?
- 当集群 master 候选数量不小于 3 个时,可以通过设置最少投票通过数量
(discovery.zen.minimum_master_nodes)超过所有候选节点一半以上 来解决脑裂问题;
- 当候选数量为两个时,只能修改为唯一的一个 master 候选,其他作为data 节点,避免脑裂问题。
解释一下 Elasticsearch 集群中的 索引的概念 ?
Elasticsearch 集群可以包含多个索引,与关系数据库相比,它们相当于数据库 表。
你可以列出 Elasticsearch 各种类型的分析器吗?
Elasticsearch Analyzer 的类型为内置分析器和自定义分析器。
Standard Analyzer 标准分析器是默认分词器,如果未指定,则使用该分词器。 它基于 Unicode 文本分割算法,适用于大多数语言。
Whitespace Analyzer
基于空格字符切词。
Stop Analyzer
在 simple Analyzer 的基础上,移除停用词。
Keyword Analyzer 不切词,将输入的整个串一起返回。
自定义分词器的模板
自定义分词器的在 Mapping 的 Setting 部分设置:
PUT my\_custom\_index
{
    "settings":{
        "analysis":{
            "char\_filter":{

            },
            "tokenizer":{

            },
            "filter":{

            },
            "analyzer":{

            }
        }
    }
}其中: “char_filter”:{},——对应字符过滤部分; “tokenizer”:{},——对应文本切分为分词部分;
“filter”:{},——对应分词后再过滤部分; “analyzer”:{}——对应分词器组成部分,其中会包含:1. 2. 3。
解释一下 Elasticsearch Node?
节点是 Elasticsearch 的实例。实际业务中,我们会说:ES 集群包含 3 个节 点、7 个节点。
这里节点实际就是:一个独立的 Elasticsearch 进程,一般将一个节点部署到 一台独立的服务器或者虚拟机、容器中。 不同节点根据角色不同,可以划分为:
主节点
帮助配置和管理在整个集群中添加和删除节点。
数据节点
存储数据并执行诸如 CRUD(创建/读取/更新/删除)操作,对数据进行搜索和 聚合的操作。
客户端节点(或者说:协调节点)
将集群请求转发到主节点,将与数据相 关的请求转发到数据节点。
摄取节点
用于在索引之前对文档进行预处理。
在安装 Elasticsearch 时,请说明不同的软件包及其重要性?
这个貌似没什么好说的,去官方文档下载对应操作系统安装包即可。 部分功能是收费的,如机器学习、高级别 kerberos 认证安全等选型要知悉。
Elasticsearch 在部署时,对 Linux 的设置有哪些优化方法?
关闭缓存 swap;
堆内存设置为:Min(节点内存/2, 32GB);
设置最大文件句柄数;
线程池+队列大小根据业务需要做调整;
磁盘存储 raid 方式——存储有条件使用 RAID10,增加单节点性能以及避 免单节点存储故障。
请解释有关 Elasticsearch 的 NRT?
从文档索引(写入)到可搜索到之间的延迟默认一秒钟,因此 Elasticsearch 是 近实时(NRT)搜索平台。
也就是说:文档写入,最快一秒钟被索引到,不能再快了。 写入调优的时候,我们通常会动态调整:refresh_interval = 30s 或者更达 值,以使得写入数据更晚一点时间被搜索到。
elasticsearch 的 document 设计
在使用 es 时 避免使用复杂的查询语句(Join 、聚合),就是在建立索引时, 就根据查询语句建立好对应的元数据。
elasticsearch 了解多少,说说你们公司 es 的集群架构,索引数据大小,分片有多少,以及一些调优手段 。
面试官:想了解应聘者之前公司接触的 ES 使用场景、规模,有没有做过比较大
规模的索引设计、规划、调优。
解答:
如实结合自己的实践场景回答即可。
比如:ES 集群架构 13 个节点,索引根据通道不同共 20+索引,根据日期,每日
递增 20+,索引:10 分片,每日递增 1 亿+数据,
每个通道每天索引大小控制:150GB 之内。
仅索引层面调优手段:
1.1、设计阶段调优
1、根据业务增量需求,采取基于日期模板创建索引,通过 roll over API 滚动索
引;
2、使用别名进行索引管理;
3、每天凌晨定时对索引做 force_merge 操作,以释放空间;
4、采取冷热分离机制,热数据存储到 SSD,提高检索效率;冷数据定期进行 shrink
操作,以缩减存储;
5、采取 curator 进行索引的生命周期管理;
6、仅针对需要分词的字段,合理的设置分词器;
7、Mapping 阶段充分结合各个字段的属性,是否需要检索、是否需要存储等。……..
1.2、写入调优
1、写入前副本数设置为 0;
2、写入前关闭 refresh_interval 设置为-1,禁用刷新机制;
3、写入过程中:采取 bulk 批量写入;
4、写入后恢复副本数和刷新间隔;
5、尽量使用自动生成的 id。
1.3、查询调优
1、禁用 wildcard;
2、禁用批量 terms(成百上千的场景);
3、充分利用倒排索引机制,能 keyword 类型尽量 keyword;
4、数据量大时候,可以先基于时间敲定索引再检索;
5、设置合理的路由机制。
1.4、其他调优
部署调优,业务调优等。
上面的提及一部分,面试者就基本对你之前的实践或者运维经验有所评估了。
elasticsearch 的倒排索引是什么
面试官:想了解你对基础概念的认知。
解答:通俗解释一下就可以。
传统的我们的检索是通过文章,逐个遍历找到对应关键词的位置。
而倒排索引,是通过分词策略,形成了词和文章的映射关系表,这种词典+映射表
即为倒排索引。
有了倒排索引,就能实现 o(1)时间复杂度的效率检索文章了,极大的提高了
检索效率。
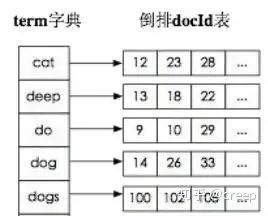
学术的解答方式:
倒排索引,相反于一篇文章包含了哪些词,它从词出发,记载了这个词在哪些文
档中出现过,由两部分组成——词典和倒排表。
加分项:倒排索引的底层实现是基于:FST(Finite State Transducer)数据结
构。
lucene 从 4+版本后开始大量使用的数据结构是 FST。FST 有两个优点:
1、空间占用小。通过对词典中单词前缀和后缀的重复利用,压缩了存储空间;
2、查询速度快。O(len(str))的查询时间复杂度。
elasticsearch 索引数据多了怎么办,如何调优,部署
面试官:想了解大数据量的运维能力。
解答:索引数据的规划,应在前期做好规划,正所谓“设计先行,编码在后”,
这样才能有效的避免突如其来的数据激增导致集群处理能力不足引发的线上客户
检索或者其他业务受到影响。
如何调优,正如问题 1 所说,这里细化一下:
3.1 动态索引层面
基于模板+时间+rollover api 滚动创建索引,举例:设计阶段定义:blog 索
引的模板格式为:blog_index_时间戳的形式,每天递增数据。
这样做的好处:不至于数据量激增导致单个索引数据量非常大,接近于上线 2 的
32 次幂-1,索引存储达到了 TB+甚至更大。
一旦单个索引很大,存储等各种风险也随之而来,所以要提前考虑+及早避免。
3.2 存储层面
冷热数据分离存储,热数据(比如最近 3 天或者一周的数据),其余为冷数据。
对于冷数据不会再写入新数据,可以考虑定期 force_merge 加 shrink 压缩操作,
节省存储空间和检索效率。
3.3 部署层面
一旦之前没有规划,这里就属于应急策略。
结合 ES 自身的支持动态扩展的特点,动态新增机器的方式可以缓解集群压力,注
意:如果之前主节点等规划合理,不需要重启集群也能完成动态新增的。
elasticsearch 是如何实现 master 选举的
面试官:想了解 ES 集群的底层原理,不再只关注业务层面了。
解答:
前置前提:
1、只有候选主节点(master:true)的节点才能成为主节点。
2、最小主节点数(min_master_nodes)的目的是防止脑裂。
这个我看了各种网上分析的版本和源码分析的书籍,云里雾里。
核对了一下代码,核心入口为 findMaster,选择主节点成功返回对应 Master,否
则返回 null。选举流程大致描述如下:
第一步:确认候选主节点数达标,elasticsearch.yml 设置的值
discovery.zen.minimum_master_nodes;
第二步:比较:先判定是否具备 master 资格,具备候选主节点资格的优先返回;
若两节点都为候选主节点,则 id 小的值会主节点。注意这里的 id 为 string 类型。
题外话:获取节点 id 的方法。
详细描述一下 Elasticsearch 索引文档的过程
面试官:想了解 ES 的底层原理,不再只关注业务层面了。
解答:
这里的索引文档应该理解为文档写入 ES,创建索引的过程。
文档写入包含:单文档写入和批量 bulk 写入,这里只解释一下:单文档写入流程。
记住官方文档中的这个图。
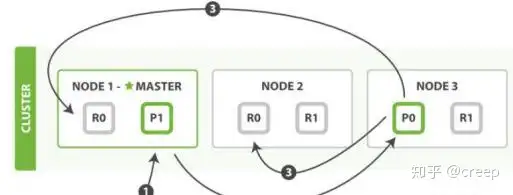
第一步:客户写集群某节点写入数据,发送请求。(如果没有指定路由/协调节点,
请求的节点扮演路由节点的角色。)
第二步:节点 1 接受到请求后,使用文档_id 来确定文档属于分片 0。请求会被转
到另外的节点,假定节点 3。因此分片 0 的主分片分配到节点 3 上。
第三步:节点 3 在主分片上执行写操作,如果成功,则将请求并行转发到节点 1
和节点 2 的副本分片上,等待结果返回。所有的副本分片都报告成功,节点 3 将
向协调节点(节点 1)报告成功,节点 1 向请求客户端报告写入成功。
如果面试官再问:第二步中的文档获取分片的过程?
回答:借助路由算法获取,路由算法就是根据路由和文档 id 计算目标的分片 id 的
过程。
1shard = hash(_routing) % (num_of_primary_shards)
详细描述一下 Elasticsearch 搜索的过程?
面试官:想了解 ES 搜索的底层原理,不再只关注业务层面了。
解答:
搜索拆解为“query then fetch” 两个阶段。
query 阶段的目的:定位到位置,但不取。
步骤拆解如下:
1、假设一个索引数据有 5 主+1 副本 共 10 分片,一次请求会命中(主或者副本
分片中)的一个。
2、每个分片在本地进行查询,结果返回到本地有序的优先队列中。
3、第 (2)步骤的结果发送到协调节点,协调节点产生一个全局的排序列表。
fetch 阶段的目的:取数据。
路由节点获取所有文档,返回给客户端。
Elasticsearch 在部署时,对 Linux 的设置有哪些优化方法
面试官:想了解对 ES 集群的运维能力。
解答:
1、关闭缓存 swap;
2、堆内存设置为:Min(节点内存/2, 32GB);
3、设置最大文件句柄数;
4、线程池+队列大小根据业务需要做调整;
5、磁盘存储 raid 方式——存储有条件使用 RAID10,增加单节点性能以及避免单
节点存储故障。
lucence 内部结构是什么?
面试官:想了解你的知识面的广度和深度。
解答:
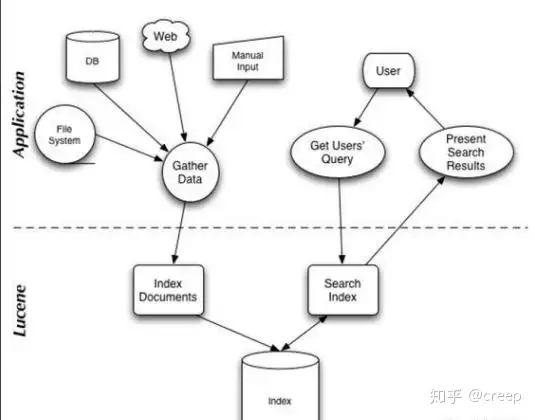
Lucene 是有索引和搜索的两个过程,包含索引创建,索引,搜索三个要点。可以
基于这个脉络展开一些。
最近面试一些公司,被问到的关于 Elasticsearch 和搜索引擎相关的问题,以及自
己总结的回答。
Elasticsearch 是如何实现 Master 选举的?
1、Elasticsearch 的选主是 ZenDiscovery 模块负责的,主要包含 Ping(节点之
间通过这个 RPC 来发现彼此)和 Unicast(单播模块包含一个主机列表以控制哪
些节点需要 ping 通)这两部分;
2、对所有可以成为 master 的节点(node.master: true)根据 nodeId 字典排
序,每次选举每个节点都把自己所知道节点排一次序,然后选出第一个(第 0 位)
节点,暂且认为它是 master 节点。
3、如果对某个节点的投票数达到一定的值(可以成为 master 节点数 n/2+1)并
且该节点自己也选举自己,那这个节点就是 master。否则重新选举一直到满足上
述条件。
4、补充:master 节点的职责主要包括集群、节点和索引的管理,不负责文档级
别的管理;data 节点可以关闭 http 功能*。
Elasticsearch 中的节点(比如共 20 个),其中的 10 个
选了一个 master,另外 10 个选了另一个 master,怎么办?
1、当集群 master 候选数量不小于 3 个时,可以通过设置最少投票通过数量
(discovery.zen.minimum_master_nodes)超过所有候选节点一半以上来解
决脑裂问题;
2、当候选数量为两个时,只能修改为唯一的一个 master 候选,其他作为 data
节点,避免脑裂问题。
客户端在和集群连接时,如何选择特定的节点执行请求的?
1、TransportClient 利用 transport 模块远程连接一个 elasticsearch 集群。它并
不加入到集群中,只是简单的获得一个或者多个初始化的 transport 地址,并以 轮
询 的方式与这些地址进行通信。
详细描述一下 Elasticsearch 索引文档的过程。
协调节点默认使用文档 ID 参与计算(也支持通过 routing),以便为路由提供合
适的分片。
shard = hash(document_id) % (num_of_primary_shards)
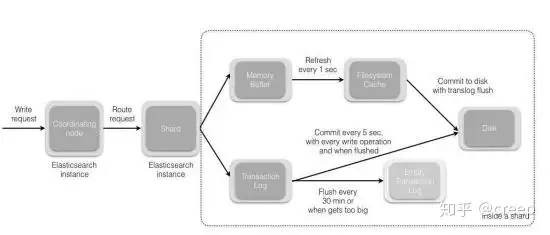
1、当分片所在的节点接收到来自协调节点的请求后,会将请求写入到 Memory
Buffer,然后定时(默认是每隔 1 秒)写入到 Filesystem Cache,这个从 Momery
Buffer 到 Filesystem Cache 的过程就叫做 refresh;
2、当然在某些情况下,存在 Momery Buffer 和 Filesystem Cache 的数据可能会
丢失,ES 是通过 translog 的机制来保证数据的可靠性的。其实现机制是接收到请
求后,同时也会写入到 translog 中,当 Filesystem cache 中的数据写入到磁盘中
时,才会清除掉,这个过程叫做 flush;
3、在 flush 过程中,内存中的缓冲将被清除,内容被写入一个新段,段的 fsync
将创建一个新的提交点,并将内容刷新到磁盘,旧的 translog 将被删除并开始一
个新的 translog。
4、flush 触发的时机是定时触发(默认 30 分钟)或者 translog 变得太大(默认
为 512M)时;
补充:关于 Lucene 的 Segement:
1、Lucene 索引是由多个段组成,段本身是一个功能齐全的倒排索引。
2、段是不可变的,允许 Lucene 将新的文档增量地添加到索引中,而不用从头重
建索引。
3、对于每一个搜索请求而言,索引中的所有段都会被搜索,并且每个段会消耗
CPU 的时钟周、文件句柄和内存。这意味着段的数量越多,搜索性能会越低。
4、为了解决这个问题,Elasticsearch 会合并小段到一个较大的段,提交新的合并
段到磁盘,并删除那些旧的小段。
详细描述一下 Elasticsearch 更新和删除文档的过程。
1、删除和更新也都是写操作,但是 Elasticsearch 中的文档是不可变的,因此不
能被删除或者改动以展示其变更;
2、磁盘上的每个段都有一个相应的.del 文件。当删除请求发送后,文档并没有真
的被删除,而是在.del 文件中被标记为删除。该文档依然能匹配查询,但是会在
结果中被过滤掉。当段合并时,在.del 文件中被标记为删除的文档将不会被写入
新段。
3、在新的文档被创建时,Elasticsearch 会为该文档指定一个版本号,当执行更新
时,旧版本的文档在.del 文件中被标记为删除,新版本的文档被索引到一个新段。
旧版本的文档依然能匹配查询,但是会在结果中被过滤掉。
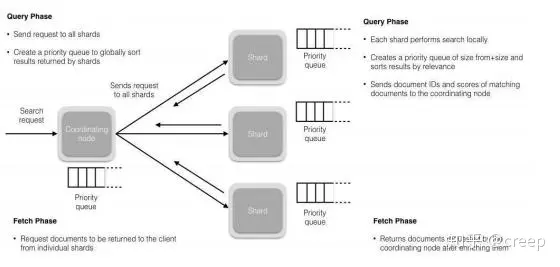
详细描述一下 Elasticsearch 搜索的过程。
1、搜索被执行成一个两阶段过程,我们称之为 Query Then Fetch;
2、在初始查询阶段时,查询会广播到索引中每一个分片拷贝(主分片或者副本分
片)。 每个分片在本地执行搜索并构建一个匹配文档的大小为 from + size 的
优先队列。
PS:在搜索的时候是会查询 Filesystem Cache 的,但是有部分数据还在 Memory
Buffer,所以搜索是近实时的。
3、每个分片返回各自优先队列中 所有文档的 ID 和排序值 给协调节点,它合并
这些值到自己的优先队列中来产生一个全局排序后的结果列表。
4、接下来就是 取回阶段,协调节点辨别出哪些文档需要被取回并向相关的分片
提交多个 GET 请求。每个分片加载并 丰富 文档,如果有需要的话,接着返回
文档给协调节点。一旦所有的文档都被取回了,协调节点返回结果给客户端。
5、补充:Query Then Fetch 的搜索类型在文档相关性打分的时候参考的是本分
片的数据,这样在文档数量较少的时候可能不够准确,DFS Query Then Fetch 增
加了一个预查询的处理,询问 Term 和 Document frequency,这个评分更准确,
但是性能会变差。*
Elasticsearch 在部署时,对 Linux 的设置有哪些优化方法?
1、64 GB 内存的机器是非常理想的, 但是 32 GB 和 16 GB 机器也是很常见的。
少于 8 GB 会适得其反。
2、如果你要在更快的 CPUs 和更多的核心之间选择,选择更多的核心更好。多
个内核提供的额外并发远胜过稍微快一点点的时钟频率。
3、如果你负担得起 SSD,它将远远超出任何旋转介质。 基于 SSD 的节点,查
询和索引性能都有提升。如果你负担得起,SSD 是一个好的选择。
4、即使数据中心们近在咫尺,也要避免集群跨越多个数据中心。绝对要避免集群
跨越大的地理距离。
5、请确保运行你应用程序的 JVM 和服务器的 JVM 是完全一样的。 在
Elasticsearch 的几个地方,使用 Java 的本地序列化。
6、通过设置 gateway.recover_after_nodes、gateway.expected_nodes、
gateway.recover_after_time 可以在集群重启的时候避免过多的分片交换,这可
能会让数据恢复从数个小时缩短为几秒钟。
7、Elasticsearch 默认被配置为使用单播发现,以防止节点无意中加入集群。只
有在同一台机器上运行的节点才会自动组成集群。最好使用单播代替组播。
8、不要随意修改垃圾回收器(CMS)和各个线程池的大小。
9、把你的内存的(少于)一半给 Lucene(但不要超过 32 GB!),通过
ES_HEAP_SIZE 环境变量设置。
10、内存交换到磁盘对服务器性能来说是致命的。如果内存交换到磁盘上,一个
100 微秒的操作可能变成 10 毫秒。 再想想那么多 10 微秒的操作时延累加起
来。 不难看出 swapping 对于性能是多么可怕。
11、Lucene 使用了大量 的文件。同时,Elasticsearch 在节点和 HTTP 客户端
之间进行通信也使用了大量的套接字。 所有这一切都需要足够的文件描述符。你
应该增加你的文件描述符,设置一个很大的值,如 64,000。
补充:索引阶段性能提升方法
1、使用批量请求并调整其大小:每次批量数据 5–15 MB 大是个不错的起始点。
2、存储:使用 SSD
3、段和合并:Elasticsearch 默认值是 20 MB/s,对机械磁盘应该是个不错的设
置。如果你用的是 SSD,可以考虑提高到 100–200 MB/s。如果你在做批量导入,
完全不在意搜索,你可以彻底关掉合并限流。另外还可以增加
index.translog.flush_threshold_size 设置,从默认的 512 MB 到更大一些的
值,比如 1 GB,这可以在一次清空触发的时候在事务日志里积累出更大的段。
4、如果你的搜索结果不需要近实时的准确度,考虑把每个索引的
index.refresh_interval 改到 30s。
5、如果你在做大批量导入,考虑通过设置 index.number_of_replicas: 0 关闭副
本。
对于 GC 方面,在使用 Elasticsearch 时要注意什么?
1、SEE:https://elasticsearch.cn/article/32
2、倒排词典的索引需要常驻内存,无法 GC,需要监控 data node 上 segment
memory 增长趋势。
3、各类缓存,field cache, filter cache, indexing cache, bulk queue 等等,要
设置合理的大小,并且要应该根据最坏的情况来看 heap 是否够用,也就是各类缓
存全部占满的时候,还有 heap 空间可以分配给其他任务吗?避免采用 clear cache
等“自欺欺人”的方式来释放内存。
4、避免返回大量结果集的搜索与聚合。确实需要大量拉取数据的场景,可以采用
scan & scroll api 来实现。
5、cluster stats 驻留内存并无法水平扩展,超大规模集群可以考虑分拆成多个集
群通过 tribe node 连接。
6、想知道 heap 够不够,必须结合实际应用场景,并对集群的 heap 使用情况做
持续的监控。
Elasticsearch 对于大数据量(上亿量级)的聚合如何实现?
Elasticsearch 提供的首个近似聚合是 cardinality 度量。它提供一个字段的基数,
即该字段的 distinct 或者 unique 值的数目。它是基于 HLL 算法的。HLL 会先对
我们的输入作哈希运算,然后根据哈希运算的结果中的 bits 做概率估算从而得到
基数。其特点是:可配置的精度,用来控制内存的使用(更精确 = 更多内存);
小的数据集精度是非常高的;我们可以通过配置参数,来设置去重需要的固定内
存使用量。无论数千还是数十亿的唯一值,内存使用量只与你配置的精确度相关。
在并发情况下,Elasticsearch 如果保证读写一致?
1、可以通过版本号使用乐观并发控制,以确保新版本不会被旧版本覆盖,由应用
层来处理具体的冲突;
2、另外对于写操作,一致性级别支持 quorum/one/all,默认为 quorum,即只
有当大多数分片可用时才允许写操作。但即使大多数可用,也可能存在因为网络
等原因导致写入副本失败,这样该副本被认为故障,分片将会在一个不同的节点
上重建。
3、对于读操作,可以设置 replication 为 sync(默认),这使得操作在主分片和副
本分片都完成后才会返回;如果设置 replication 为 async 时,也可以通过设置搜
索请求参数_preference 为 primary 来查询主分片,确保文档是最新版本。
如何监控 Elasticsearch 集群状态?
Marvel 让你可以很简单的通过 Kibana 监控 Elasticsearch。你可以实时查看你
的集群健康状态和性能,也可以分析过去的集群、索引和节点指标。
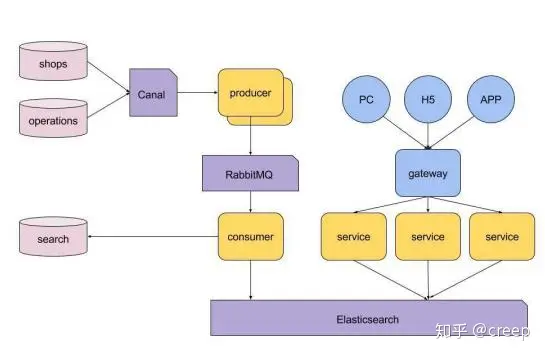
介绍下你们电商搜索的整体技术架构。
介绍一下你们的个性化搜索方案?
SEE 基于 word2vec 和 Elasticsearch 实现个性化搜索
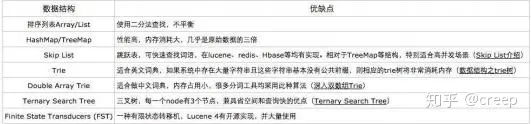
是否了解字典树?
常用字典数据结构如下所示:
Trie 的核心思想是空间换时间,利用字符串的公共前缀来降低查询时间的开销以
达到提高效率的目的。它有 3 个基本性质:
1、根节点不包含字符,除根节点外每一个节点都只包含一个字符。
2、从根节点到某一节点,路径上经过的字符连接起来,为该节点对应的字符串。
3、每个节点的所有子节点包含的字符都不相同。
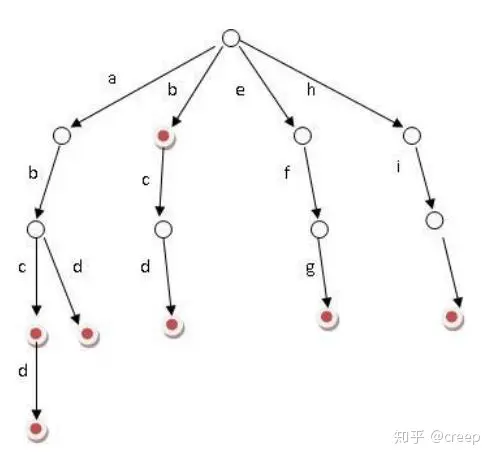
1、可以看到,trie 树每一层的节点数是 26^i 级别的。所以为了节省空间,我们
还可以用动态链表,或者用数组来模拟动态。而空间的花费,不会超过单词数×单
词长度。
2、实现:对每个结点开一个字母集大小的数组,每个结点挂一个链表,使用左儿
子右兄弟表示法记录这棵树;
3、对于中文的字典树,每个节点的子节点用一个哈希表存储,这样就不用浪费太
大的空间,而且查询速度上可以保留哈希的复杂度 O(1)。
拼写纠错是如何实现的?
1、拼写纠错是基于编辑距离来实现;编辑距离是一种标准的方法,它用来表示经
过插入、删除和替换操作从一个字符串转换到另外一个字符串的最小操作步数;
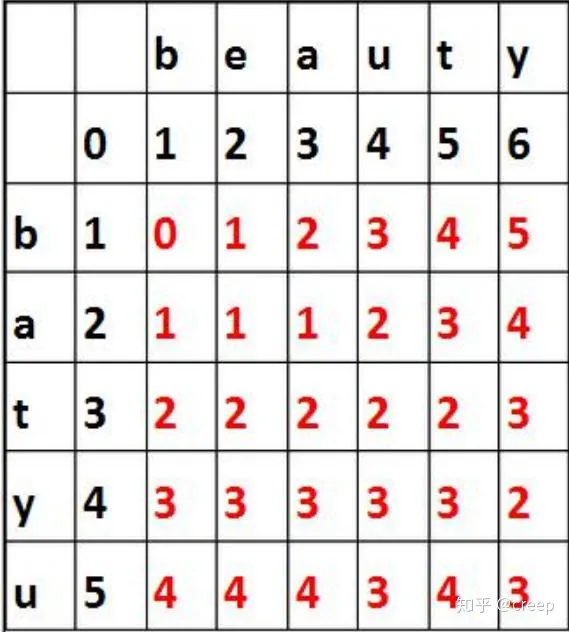
2、编辑距离的计算过程:比如要计算 batyu 和 beauty 的编辑距离,先创建一个
7×8 的表(batyu 长度为 5,coffee 长度为 6,各加 2),接着,在如下位置填入
黑色数字。其他格的计算过程是取以下三个值的最小值:
如果最上方的字符等于最左方的字符,则为左上方的数字。否则为左上方的数字
+1。(对于 3,3 来说为 0)
左方数字+1(对于 3,3 格来说为 2)
上方数字+1(对于 3,3 格来说为 2)
最终取右下角的值即为编辑距离的值 3。
对于拼写纠错,我们考虑构造一个度量空间(Metric Space),该空间内任何关
系满足以下三条基本条件:
d(x,y) = 0 -- 假如 x 与 y 的距离为 0,则 x=y
d(x,y) = d(y,x) -- x 到 y 的距离等同于 y 到 x 的距离
d(x,y) + d(y,z) >= d(x,z) -- 三角不等式
1、根据三角不等式,则满足与 query 距离在 n 范围内的另一个字符转 B,其与 A
的距离最大为 d+n,最小为 d-n。
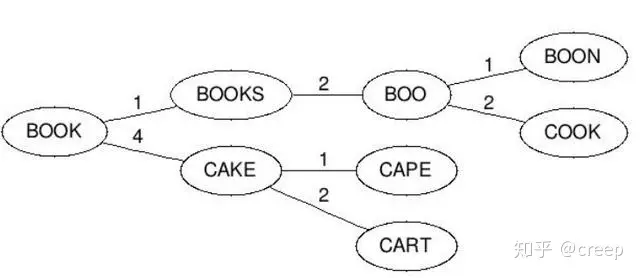
2、BK 树的构造就过程如下:每个节点有任意个子节点,每条边有个值表示编辑
距离。所有子节点到父节点的边上标注 n 表示编辑距离恰好为 n。比如,我们有棵
树父节点是”book”和两个子节点”cake”和”books”,”book”到”books”
的边标号 1,”book”到”cake”的边上标号 4。从字典里构造好树后,无论何
时你想插入新单词时,计算该单词与根节点的编辑距离,并且查找数值为
d(neweord, root)的边。递归得与各子节点进行比较,直到没有子节点,你就可
以创建新的子节点并将新单词保存在那。比如,插入”boo”到刚才上述例子的树
中,我们先检查根节点,查找 d(“book”, “boo”) = 1 的边,然后检查标号为
1 的边的子节点,得到单词”books”。我们再计算距离 d(“books”, “boo”)=2,
则将新单词插在”books”之后,边标号为 2。
3、查询相似词如下:计算单词与根节点的编辑距离 d,然后递归查找每个子节点
标号为 d-n 到 d+n(包含)的边。假如被检查的节点与搜索单词的距离 d 小于 n,
则返回该节点并继续查询。比如输入 cape 且最大容忍距离为 1,则先计算和根的
编辑距离 d(“book”, “cape”)=4,然后接着找和根节点之间编辑距离为 3 到5 的,这
个就找到了 cake 这个节点,计算 d(“cake”, “cape”)=1,满足条件
所以返回 cake,然后再找和 cake 节点编辑距离是 0 到 2 的,分别找到 cape 和
cart 节点,这样就得到 cape 这个满足条件的结果。
ES中mapping是什么,你知道es哪些数据类型?
https://live.csdn.net/v/embed/198047
mapping是什么,你知道ES的哪些数据类型
mapping解释
ES中的mapping有点类似与RDB中“表结构”的概念,在MySQL中,表结构里包含了字段名称,字段的类型还有索引信息等。在Mapping里也包含了一些属性,比如字段名称、类型、字段使用的分词器、是否评分、是否创建索引等属性,并且在ES中一个字段可以有对个类型。分词器、评分等概念在后面的课程讲解。
ES数据类型
常见类型
- 数字类型:long integer short byte double float half_float scaled_float unsigned_long
- Keywords: 3. keyword:适用于索引结构化的字段,可以用于过滤、排序、聚合。keyword类型的字段只能通过精确值(exact value)搜索到。Id应该用keyword。keyword字段通常用于排序,汇总和Term查询,例如
term。 4. constant_keyword:始终包含相同值的关键字字段 5. wildcard:可针对类似grep的通配符查询优化日志行和类似的关键字值 - dates(时间类型):包括
date和date_nanos. - alias:为现有字段定义别名。
- text:当一个字段是要被全文搜索的,比如Email内容、产品描述,这些字段应该使用text类型。设置text类型以后,字段内容会被分析,在生成倒排索 引以前,字符串会被分析器分成一个一个词项。text类型的字段不用于排序,很少用于聚合。(解释一下为啥不会为text创建正排索引:大量堆空间,尤其是 在加载高基数text字段时。字段数据一旦加载到堆中,就在该段的生命周期内保持在那里。同样,加载字段数据是一个昂贵的过程,可能导致用户遇到延迟问 题。这就是默认情况下禁用字段数据的原因)
对象关系类型
- object:用于单个JSON对象
- nested:用于JSON对象数组
- join:为同一索引中的文档定义父/子关系。
结构化类型
- geo-point:纬度/经度积分
- geo-shape:用于多边形等复杂形状
- point:笛卡尔坐标点
- shape:笛卡尔任意几何图形
自动映射和手工映射
Dynamic field mapping:
- 整数 => long
- 浮点数 => float
- true || false => boolean
- 日期 => date
- 数组 => 取决于数组中的第一个有效值
- 对象 => object
- 字符串 => 如果不是数字和日期类型,那会被映射为text和keyword两个类型 除了上述字段类型之外,其他类型都必须显示映射,也就是必须手工指定,因为其他类型ES无法自动识别。
Expllcit field mapping:手动映射
 PUT /product
 {
    "mappings": {
        "properties": {
            "field": {
                "mapping_parameter": "parameter_value"
            }
        }
    }
}映射参数
index:是否对创建对当前字段创建倒排索引,默认true,如果不创建索引,该字段不会通过索引被搜索到,但是仍然会在source元数据中展示
analyzer:指定分析器(character filter、tokenizer、Token filters)。
boost:对当前字段相关度的评分权重,默认1
coerce:是否允许强制类型转换 true “1”=> 1 false “1”=< 1
copy_to:该参数允许将多个字段的值复制到组字段中,然后可以将其作为单个字段进行查询
doc_values:为了提升排序和聚合效率,默认true,如果确定不需要对字段进行排序或聚合,也不需要通过脚本访问字段值,则可以禁用doc值以节省磁盘 空间(不支持text和annotated_text)
dynamic:控制是否可以动态添加新字段
- true 新检测到的字段将添加到映射中。(默认)
- false 新检测到的字段将被忽略。这些字段将不会被索引,因此将无法搜索,但仍会出现在_source返回的匹配项中。这些字段不会添加到映射中,必须显式 添加新字段。
- strict 如果检测到新字段,则会引发异常并拒绝文档。必须将新字段显式添加到映射中
eager_global_ordinals:用于聚合的字段上,优化聚合性能。
Frozen indices(冻结索引):有些索引使用率很高,会被保存在内存中,有些使用率特别低,宁愿在使用的时候重新创建,在使用完毕后丢弃数据,Frozen indices的数据命中频率小,不适用于高搜索负载,数据不会被保存在内存中,堆空间占用比普通索引少得多,Frozen indices是只读的,请求可能是秒级或者分钟级。eager_global_ordinals不适用于Frozen indices
enable:是否创建倒排索引,可以对字段操作,也可以对索引操作,如果不创建索引,让然可以检索并在_source元数据中展示,谨慎使用,该状态无法修改。fielddata:查询时内存数据结构,在首次用当前字段聚合、排序或者在脚本中使用时,需要字段为fielddata数据结构,并且创建倒排索引保存到堆中
     PUT my_index
     {
       "mappings": {
         "enabled": false
       }
}fields:给field创建多字段,用于不同目的(全文检索或者聚合分析排序)
format:格式化
   "date": {
      "type":  "date",
      "format": "yyyy-MM-dd"
}ignore_above:超过长度将被忽略
ignore_malformed:忽略类型错误
index_options:控制将哪些信息添加到反向索引中以进行搜索和突出显示。仅用于text字段
Index_phrases:提升exact_value查询速度,但是要消耗更多磁盘空间
Index_prefixes:前缀搜索
- min_chars:前缀最小长度,>0,默认2(包含)
- max_chars:前缀最大长度,<20,默认5(包含)
meta:附加元数据
normalizer:
norms:是否禁用评分(在filter和聚合字段上应该禁用)。
null_value:为null值设置默认值**
position_increment_gap:
proterties:除了mapping还可用于object的属性设置
search_analyzer:设置单独的查询时分析器:
similarity:为字段设置相关度算法,支持BM25、claassic(TF-IDF)、boolean
store:设置字段是否仅查询
term_vector**:运维参数
什么是全文检索(面试简化版)
什么是全文检索
相关度
- 搜索:有明确的查询边界,比如:where name = xxx、where age > 30
- 检索:讲究相关度,无明确的查询条件边界
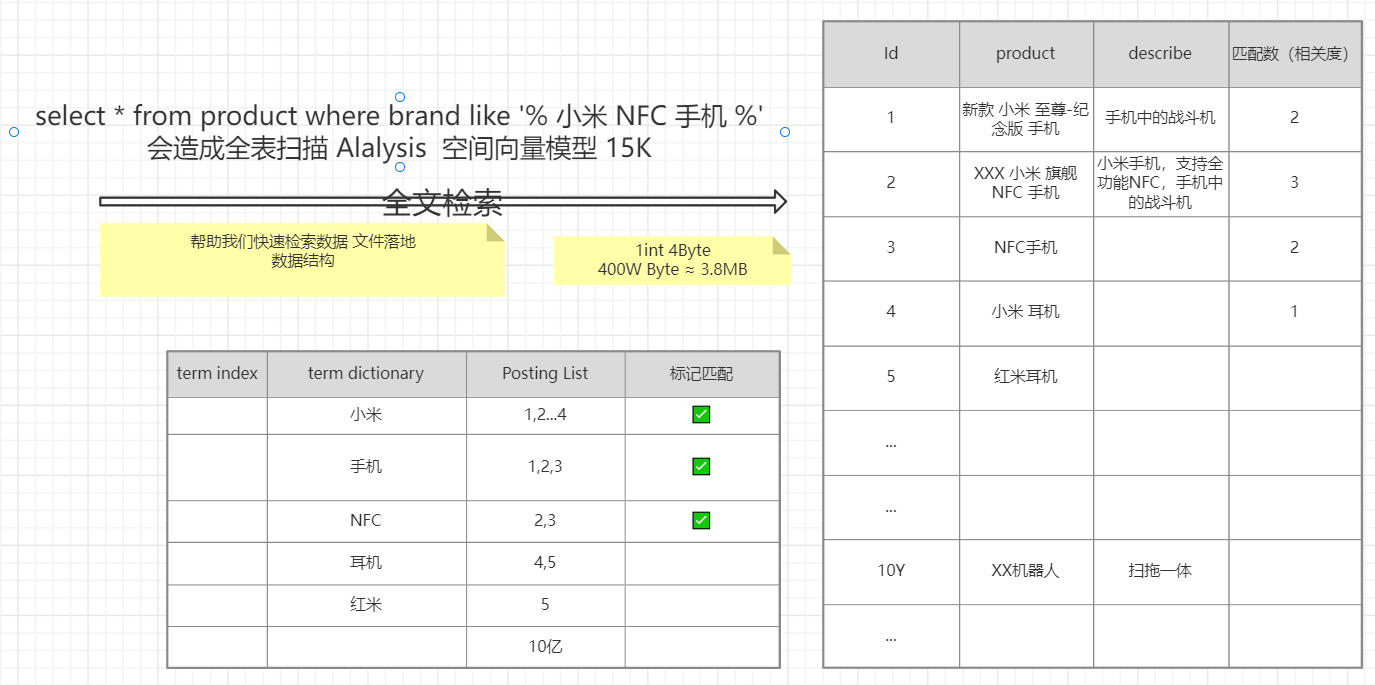
图解全文检索
 GET index/_search
 {
   "query": {
     ***
   }
}ES支持哪些类型的查询
ES支持哪些类型的查询
此题目答案不唯一,按照不同的分类方式,答案也不一样
按语言划分
- Query DSL:Domain Specific Language
- Script:脚本查询
- Aggregations:聚合查询
- SQL查询
- EQL查询
按场景划分
Query String
查询所有:
GET /product/_search带参数:
GET /product/_search?q=name:xiaomi分页:
GET /product/_search?from=0&size=2&sort=price:asc精准匹配 exact value
GET /product/_search?q=date:2021-06-01_all搜索 相当于在所有有索引的字段中检索
GET /product/_search?q=2021-06-01验证_all搜索
 PUT product
 {
   "mappings": {
     "properties": {
       "desc": {
         "type": "text",
         "index": false
       }
     }
   }
 }
 # 先初始化数据
 POST /product/_update/5
 {
   "doc": {
     "desc": "erji zhong de kendeji 2021-06-01"
   }
}全文检索-Fulltext query
```
 GET index/_search
 {
   "query": {
     ***
   }
 }
```- match:匹配包含某个term的子句
- match_all:匹配所有结果的子句
- multi_match:多字段条件
- match_phrase:短语查询,
精准查询-Term query
- term:匹配和搜索词项完全相等的结果
- term和match_phrase区别: match_phrase 会将检索关键词分词, match_phrase的分词结果必须在被检索字段的分词中都包含,而且顺序必须相同,而且默认必须都是连续的 term搜索不会将搜索词分词
- term和keyword区别 term是对于搜索词不分词, keyword是字段类型,是对于source data中的字段值不分词
- terms:匹配和搜索词项列表中任意项匹配的结果
- range:范围查找
过滤器-Filter
 GET _search
 {
   "query": {
     "constant_score": {
       "filter": {
         "term": {
           "status": "active"
         }
       }
     }
   }
}filter:query和filter的主要区别在: filter是结果导向的而query是过程导向。query倾向于“当前文档和查询的语句的相关度”而filter倾向于“当前文档和查询的条件是不是相符”。即在查询过程中,query是要对查询的每个结果计算相关性得分的,而filter不会。另外filter有相应的缓存机制,可以提高查询效率。
组合查询-Bool query
bool:可以组合多个查询条件,bool查询也是采用more_matches_is_better的机制,因此满足must和should子句的文档将会合并起来计算分值
- must:必须满足子句(查询)必须出现在匹配的文档中,并将有助于得分。
- filter:过滤器 不计算相关度分数,cache☆子句(查询)必须出现在匹配的文档中。但是不像 must查询的分数将被忽略。Filter子句在filter上下文中执行,这意味着计分被忽略,并且子句被考虑用于缓存。
- should:可能满足 or子句(查询)应出现在匹配的文档中。
- must_not:必须不满足 不计算相关度分数 not子句(查询)不得出现在匹配的文档中。子句在过滤器上下文中执行,这意味着计分被忽略,并且子句被视为用于缓存。由于忽略计分,0因此将返回所有文档的分数。
minimum_should_match:参数指定should返回的文档必须匹配的子句的数量或百分比。如果bool查询包含至少一个should子句,而没有must或 filter子句,则默认值为1。否则,默认值为0
地理位置搜索
复杂类型查询
- Object
- Nested
- Join
按数据类型(准确度)划分
- 全文检索:match
- 精确查找:term
- 模糊查询:suggester、模糊查询、通配符、正则查找
term、match、keyword的有何区别,你还知道哪些检索类型
term和match的区别
term和match
term:对搜索词不分词,不影响源数据
match:对搜索词分词,不影响源数据
term和keyword
term:检索类型
keyword:字段类型
为什么MySQL(B+Trees)不适合做全文检索?
MySQL(B+Trees)为什么不适合做全文检索
什么是索引
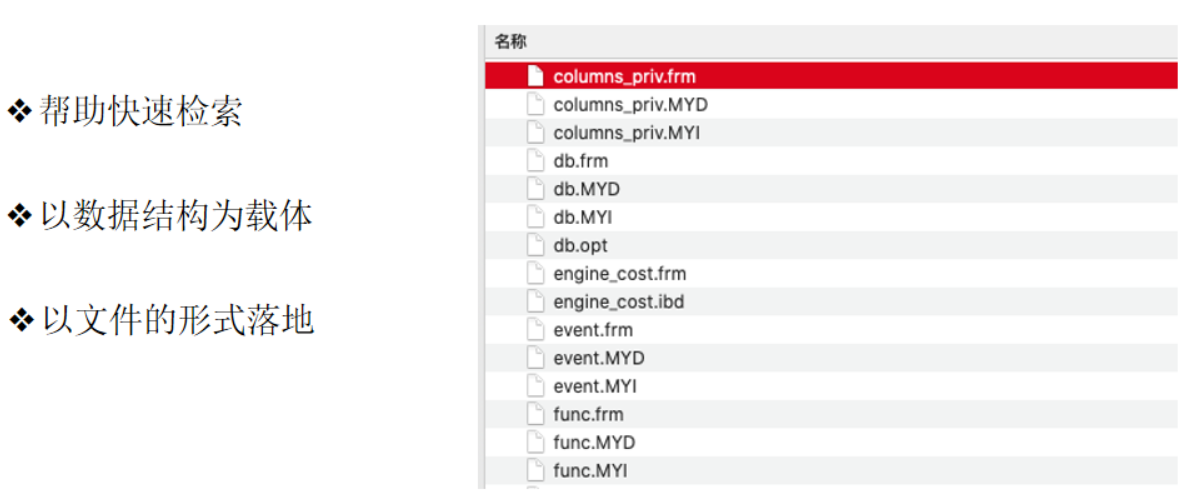
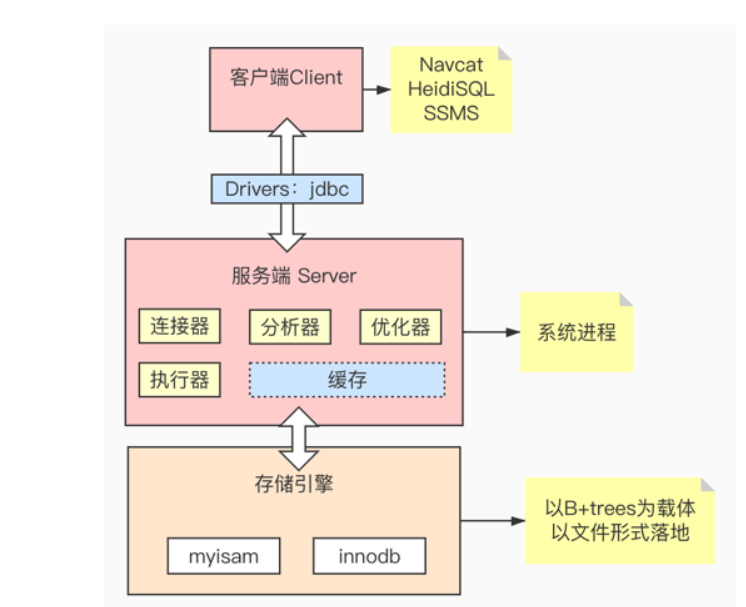
数据库的组成
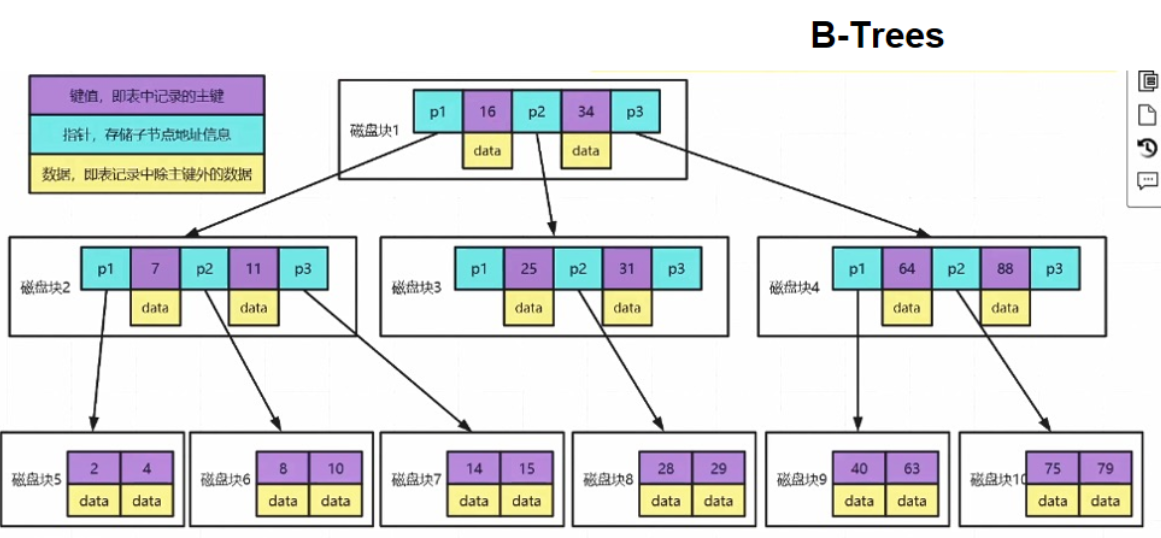
B-Trees的数据结构
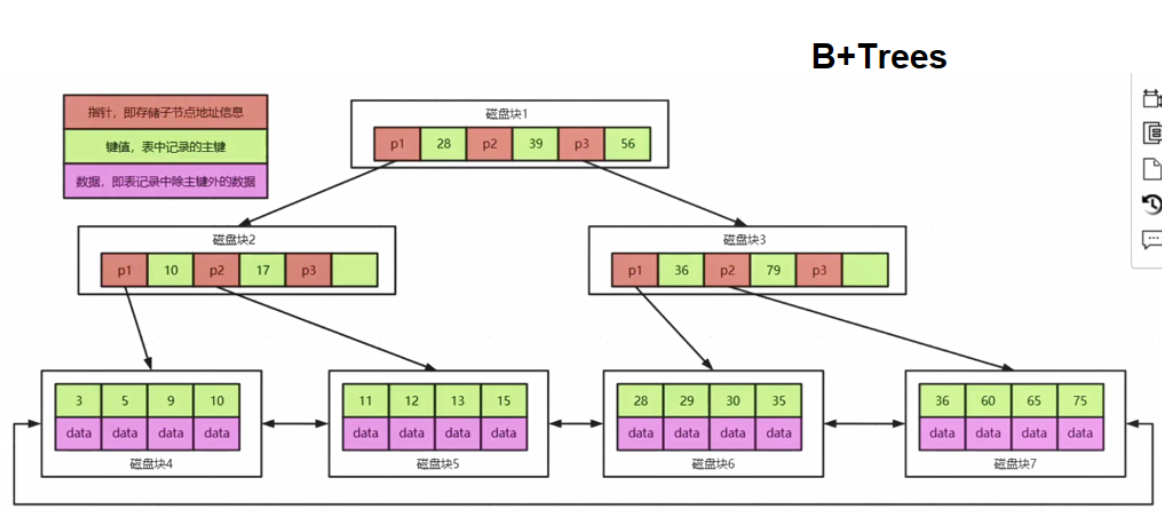
B+Trees的数据结构
B+Trees做全文检索的弊端
- 索引往往字段很长,如果使用B+trees,树可能很深,IO很可怕
- 性能无法保证并且索引会失效
- 精准度差(相关度低),并且无法和其他属性产生相关性
倒排索引的基本原理(面试简化版)
倒排索引基本原理
概念
倒排索引:“关键词”=> “文档ID”,即关键词到文档id的映射。
倒排索引的基本数据结构
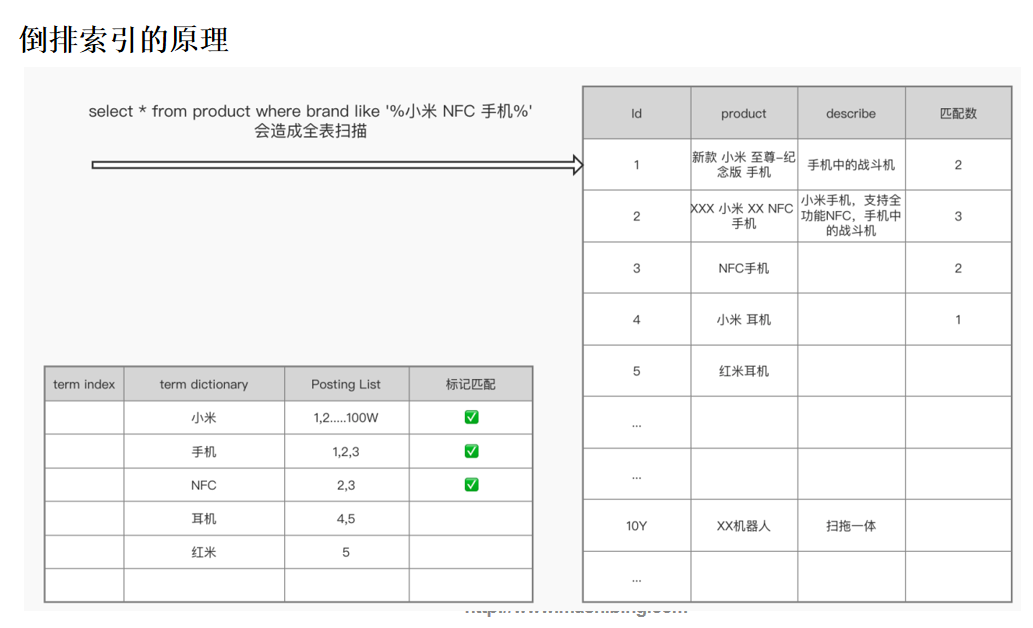
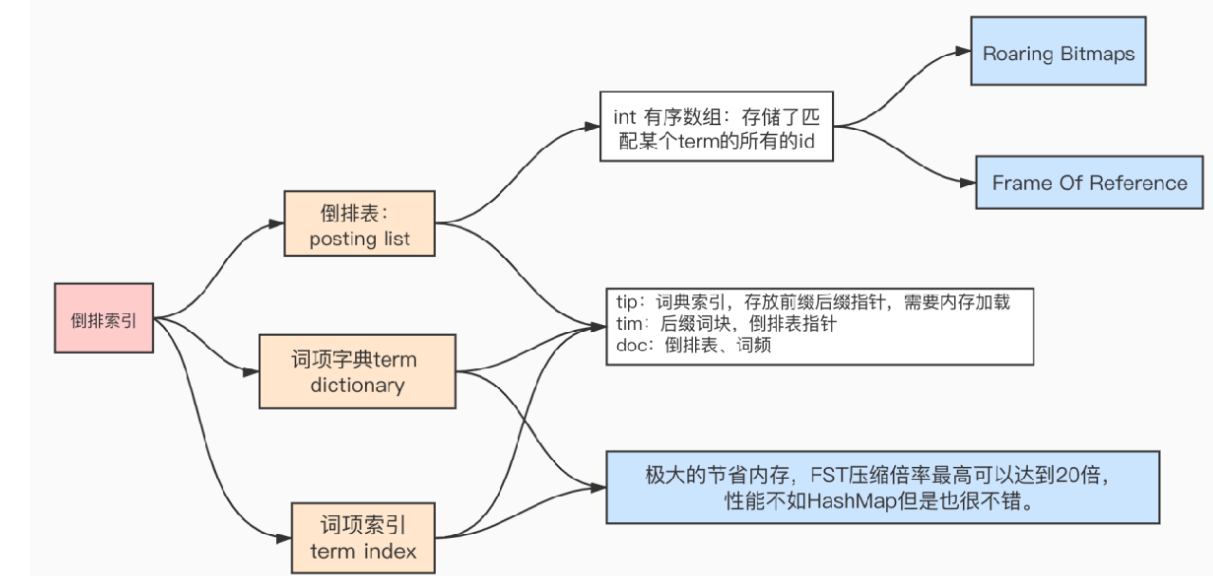
倒排表的压缩算法-1:FOR
倒排表的压缩算法:FOR
搜索引擎级别的数据量级通常通常在亿级甚至十亿级上,那么也就说如果我们对其建立倒排索引,每个字段被拆分成了若干Term,结果就有可能导致倒排索引的数据量甚至超过了source data,即便我们对倒排索引的检索不必全表扫描,但是太多的数据不管是存储成本还是查询性能可能都不是我们想要的,解决办法就是采用高效的压缩算法和快速的编码和解码算法。
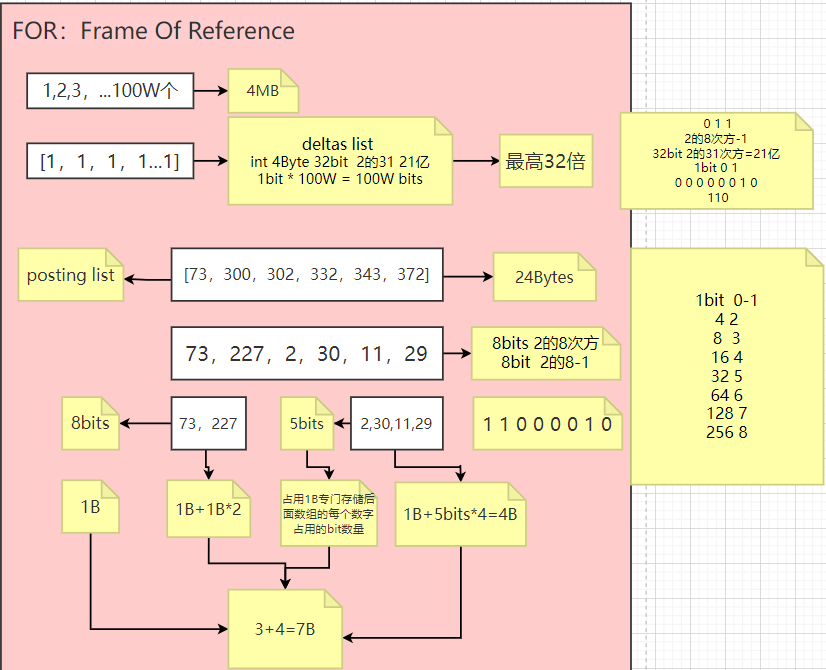
倒排表的压缩算法-2:RBM
倒排表的压缩算法:RBM
其实上述例子中的数组仍然具有一定的特殊性。因为它是一个稠密数组,可以理解为是一个取值区间波动不大的数组。如果倒排表中出现这样的情况:[1000W, 2001W, 3003W, 5248W, 9548W, 10212W, … , 21Y],情况将会特别糟糕,因为我们如果还按照FOR的压缩算法对这个数组进行压缩,我们对其计算dealta list,可以发现其每个项与前一个数字的差值仍然是一个很大的数值,也就意味着dealta list的每个元素仍然是需要很多bit来存储的。于是Lucene对于这种稀疏数组采用了另一种压缩算法:RBM(Roaring Bitmaps)
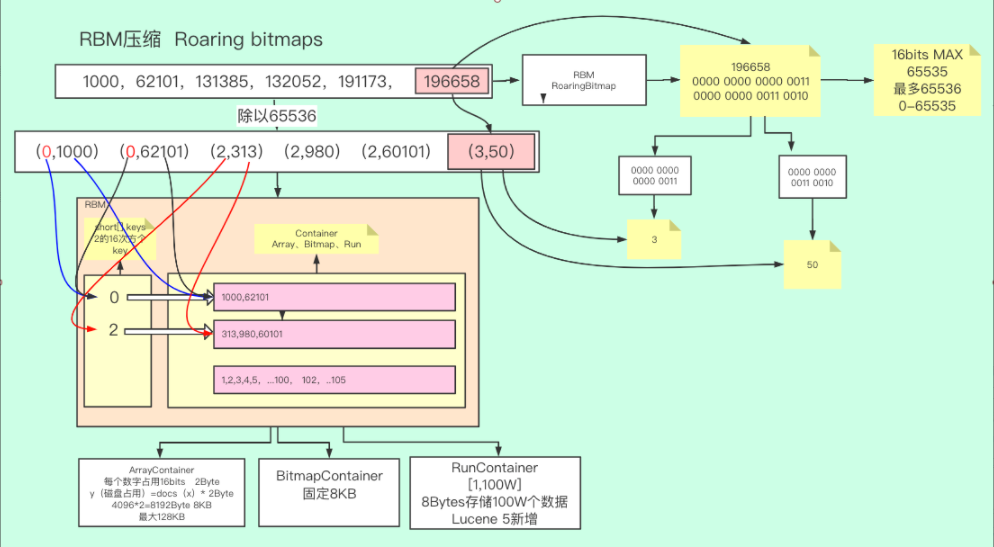
这是一个典型的稀疏型数组。在进行数据压缩的时候,其实不管何种方法,我们的最终目的都是把原来的数字转换成足够小的数字以便于我们存储,同时又必须保证压缩后的数据是可以快速解码的。“减法”不好用,这次我们尝试使用“除法”。由于无符号int类型的最大值不超过2 32 ,因此RBM的策略就是把一个int型拆成两个short型的乘机,具体做法是把数组中的每个元素对216取模,因为被除数是232除数是2 16 ,因此商和余数均小于2 16 。其实这种想法是国内开发者强行转化的逻辑,RBM算法本身的设计思路是将原数字的的32个bit分为了高16位和低16位。以原数组中的196658这个id为例,将其转化为二进制结果为 110000000000110010,我们看到其实结果是不足32bits的,但因为每个int型都是有32个bit组成的,不足32bit会在其前面补0,实际其占用的空间大小仍然为32bits,如果这一点不理解,打个比方,公交车有32个座位,无论是否坐满,都是使用了32个座位。最终196658转换成二进制就是0000 0000 0000 0011 0000 0000 0011 0010,前16位就是高16位,转换成十进制就是3,后16位也就是低16位,转换成十进制就是50,3和50分别正好是196658除以63326(2 16 )的得数和余数,换句话说,int类型的高16位和低16位分别就是其本身对216的商和模。
对数组中每个数字进行相同的操作,会得到以下结果:(0,1000)(0,62101)(2,313)(2,980)(2,60101)(3,50),其含义就是每个数字都由一个很大的数字变为了两个很小的数字,并且这两个数字都不超过65536,更重要的是,当前结果是非常适合压缩的,因为不难看出,出现了很多重复的数字,比如前两个数字的得数都是0,以及第2、3、4个数字的得数都是2。RBM使用了非常适合存储当前结果的数据结构。这种数据结构是一种类似于哈希的结构,只不过Key值是一个short有序不重复数组,用于保存每个商值,value是一个容器,保存了当前Key值对应的所有模,这些模式不重复的,因为同一个商值的余数是不会重复的。这里的容器官方称之为Container,RBM中包含三种Container,分别是ArrayContainer、BitmapContainer和RunContainer。
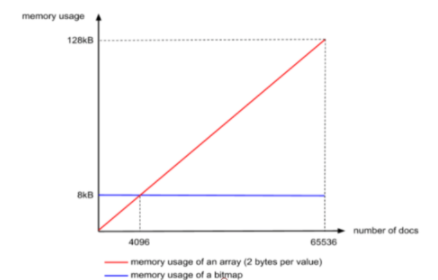
首先ArrayContainer,顾名思义,Container中实际就是一个short类型的数组,其空间占用的曲线如下图中的红色线段,注意这里是线段,因为docs的数量最大不会超过65536,其函数为 y(空间占用)=x(docs 长度) x 2Bytes,当长度达到65536极限值的时候,其占用的大小就是16bit * 65536 / 8 /1024 = 128KB,乘以65536是总bit数,除以8是换算成Byte,除以1024是换算成KB。
第二种是BitmapContainer,理解BitmapContainer之前首先要了解什么是bitmap。以往最常见的数据存储方式都是二进制进位存储,比如我们使用8个bit存储数字,如果存十进制0,那二进制就是 0 0 0 0 0 0 0 0,如果存十进制1,那就是 0 0 0 0 0 0 0 1,如果存十进制2,那就是 0 0 0 0 0 0 1 1,用到了第二个bit。这种做法在当前场景下存储效率显然不高,如果我们现在不用bit来存储数据,而是用来作为“标记”,即标记当前bit位置商是否存储了数字,出的数字值就是bit的下标,如图所示,就表示存储了2、3、5、7四个数字,第一行数字的bit仅代表当前index位置上是否存储了数字,如果存储了就记作1,否则记为0,存储的数字值就是其index,并且存储这四个数字只使用了一个字节。
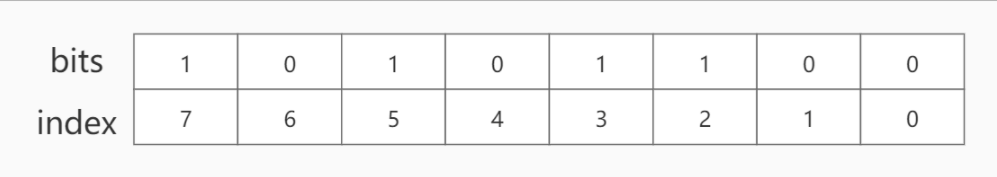
不过这种存储方式的问题就是,存储的数字不能包含重复数字,并且Bitmap的大小是固定的,不管是否存储了数值,不管存储了几个值,占用的空间都是恒定的,只和bit的长度有关系。但是我们刚才已经说过,同一个Container中的数字是不会重复的,因此这种数据类型正好适合用这种数据结构作为载体,而因为我们Container的最大容量是65536,因此Bitmap的长度固定为65536,也就是65536个bit,换算成千字节就是8KB,如上面图中的蓝色线段所示,即Lucene的RBM中BitmapContainer固定占用8KB大小的空间,通过对比可以发现,当doc的数量小于4096的时候,使用ArrayContainer更加节省空间,当doc数量大于4096的时候,使用BitmapContainer更加节省空间。
第三种Container叫RunContainer,这种类型是Lucene 5之后新增的类型,主要应用在连续数字的存储商,比如倒排表中存储的数组为 [1,2,3…100W] 这样的连续数组,如果使用RunContainer,只需存储开头和结尾两个数字:1和100W,即占用8个字节。这种存储方式的优缺点都很明显,它严重收到数字连续性的影响,连续的数字越多,它存储的效率就越高。
什么是字典树
字典树的存储和遍历过程
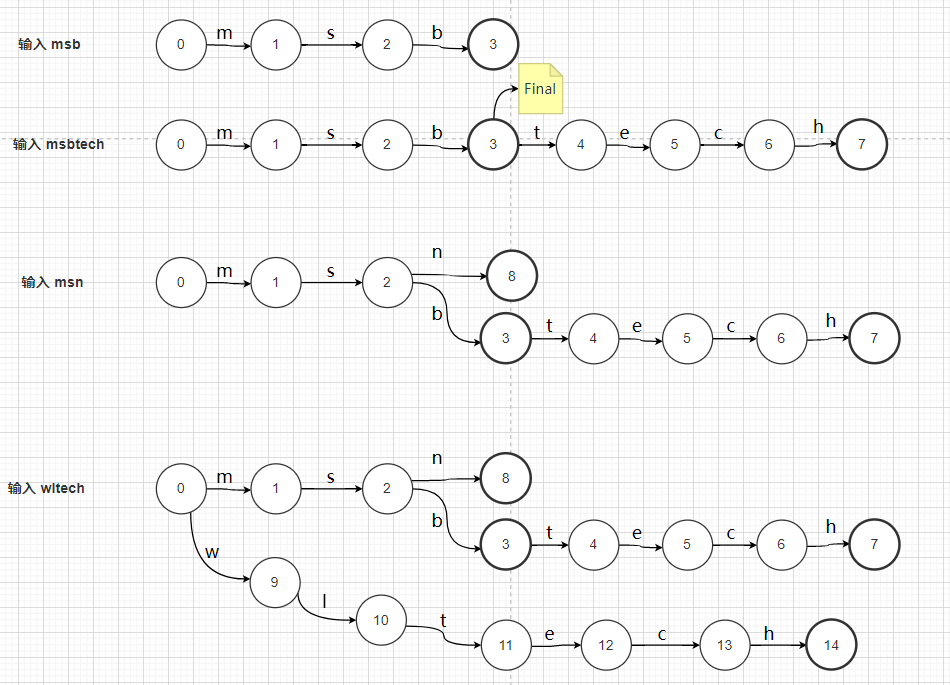
Term Dictionary是字典序非重复的K-V结构的,而通常搜索引擎级别的倒排索引,Term Dictionary动辄以“亿”起步,这势必要求我们在做数据存储时对其数据结构有极其高的要求。假设下图中英汉词典片段就是我们要存储的词项字典,遵循“通用最小化算法”对其进行数据压缩,我们就必须要考虑如何以最小的代价换区最高的效率。通过观察不难发现,无论任何一个Term,无外乎由26个英文字母组成,这也就意味越多的词项就会造成的越多的数据“重复”。这里所说的重复指的是词项之间会有很多个公共部分,如“abandon”和“abandonment”就共享了公共前缀“abandont”。我们是否可以像Java开发过程中对代码的封装那样,重复利用这一部分公共内容呢?答案是肯定的!Lucene在存储这种有重复字符的数据的时候,只会存储一次,也就是哪怕有一亿个以abandon为前缀的词项,“abandom”这个前缀也只会存储一次。这里就用到了一种我们经常用到的一种数据结构:Trie即字典树,也叫前缀树(Prefix Tree)。
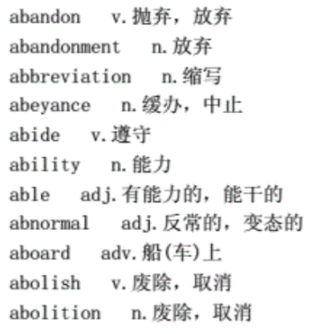
下面我们以Term Dictionary:(msb、msbtech、msn、wltech)为例,演示一下Trie是如何存储Term Dictionary的。